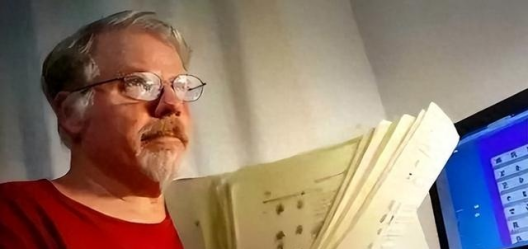
凌晨两点,美国某大学语言学系的一间办公室里,麦克·哈里森教授把面前的实验数据又看了一遍。他摘下眼镜,揉了揉发酸的眼角,对着屏幕上中英文对照的文本沉默了很久。
他随即在个人社交账号上敲下了一段话:“中文根本不是普通语言,它更像是面向未来的宇宙代码。”
这段话在发出后的几个小时内,迅速从他的学术圈扩散到更大的网络平台。评论区吵成一片:有人附和,有人觉得夸张,还有人嘲讽这位教授“学了三年中文就不知道天高地厚了”。
而这一切的起点,是三年前他决定系统学习中文。
在这之前,哈里森教授的研究方向是非常典型的印欧语系比较语言学。他的研究对象是英语、法语、德语,长期关注不同语言在信息传递效率上的差异,以及大脑在解码不同语言时的认知负荷。
他对字母文字体系的熟悉是刻在骨子里的。他曾经在自己的著作里写过:“字母文字是人类信息编码史上最高效的发明,拼音系统让语音与书写实现了最优解耦。”
在他的预想里,中文和其他语言一样,再复杂也只是词汇和语法的不同,底层逻辑不会跳出已有的语言学的框架。他给自己的规划是一年:一年时间,足够他掌握中文的基础规则,能够流畅阅读学术文献,日常交流也不在话下。他甚至跟同事开玩笑说:“先学一年试试,不行就换一门简单点的。”
他幸运地,或者说不幸地,找对了门。他没有被汉字笔画难倒,也没有被声调的复杂变化打倒,真正让他崩溃的,是中文背后那套完全不同于字母文字的编码逻辑。
他的崩溃发生在学习中文第三个月的一天下午。那天他在阅读一篇关于新能源电池的中文科普文章,看到了一个词——“锂离子”。
他见过锂这个字,也查过字典,知道这是一种金属元素。他又看到了“氢”“氧”“氮”,这些字的字形中藏着某种规律,尤其是那个气字头。
他意识到,这些元素的汉语名称似乎自带一套分类方法:气字头的,是气体;金字旁的,是金属;石字旁的,是非金属固体。
他去翻查了化学元素的中文命名历史,发现这套体系竟然是一百多年前的学者们在中国引入近代化学时统一设计的。当时为了给几十个全新发现的外来元素命名,中国学者没有简单地音译,而是利用汉字的偏旁部首作为分类标识——金属元素用金字旁,气体元素用气字头,非金属固体用石字旁,液态金属用三点水。
“这就好比是给自然界的所有基本元素构建了一个二维分类表,”他后来在公开课上这么跟学生们说,“你在英语里看到Sodium,没有任何信息提示你它是金属,但是看到钠,你知道它一定有金字旁。你们能想象如果英语也按照这种逻辑造词吗?如果所有金属类元素的名字里都带一个共同的字母组合,那学化学的人要轻松多少?”
这个发现让他第一次感觉到自己面对的不是一门语言,而是一套设计极其精巧的符号系统。
更让他崩溃的是中文对新词的构造方式。他是信息语言学出身,做过大量词汇密度研究。他手里有数据:牛津英语词典收录的英语词汇总量超过六十万,并且每年以数千个新词的速度持续增长。
毕竟每出现一个新设备、新理论、新概念,英语就需要创造一个全新的拼写组合。Computer,internet,smartphone,blockchain,metaverse——这些词之间毫无关联,每一个都必须作为一个全新的记忆单元单独学习。
一个普通英语母语者,想要流畅阅读专业文献,词汇储备至少要达到一万五千到两万,还不算那些不断冒出来的新造词。
但中文在做什么?中文的常用汉字只有三千五百个左右,而就是用这三千五百个字,中文在过去几十年里轻松接纳了电脑、手机、扫码支付、高铁、人工智能、区块链、元宇宙。
这些词用的是最基础、最普通的汉字,但组合在一起就能精准地表意。“电脑”——用电的大脑;“手机”——手持的机器;“高铁”——高速行驶的轨道列车。
任何一个掌握了基础汉字的人,哪怕第一次碰到一个新词,也能从字面组合上猜到它大致的意思。
他在自己的课题实验里做了一组对照测试。同样一篇科学科普文本,分别翻译成中文、英文、法语和西班牙语,在保证信息完整对等的前提下,中译本的篇幅最短,字符数最少。
用专业的术语说,中文单位字符承载的信息密度极高。这还不是最夸张的,更夸张的是中文的压缩能力——同样的存储空间内,中文可以存放更多的信息量。
这种特性如果放在信息科学领域,对应的就是高效编码、压缩存储的核心指标。
他忍不住跟自己的博士生说:“我们的英特尔和AMD在比谁的计算能力强,而汉语的编码效率天生就比别人高一截。”
当然,这不是说中文没有入门门槛。恰恰相反,中文对于母语是字母文字的人来说,入门难度极高。汉字脱离了发音,必须单独记忆字形、读音、含义之间的联系。
声调不同,即使拼写完全相同,词义也完全不同——mā和mǎ之间只差一个声调符号,但意思是“母亲”还是“马”。
哈里森教授说,他刚开始学中文的一个多月里,几乎每天都在崩溃的边缘。这种崩溃不是觉得中文太难,而是他过去的整个学习逻辑在中文面前全部失效了。
他习惯了看词就能猜读音——英语、法语、德语都是表音文字,拼写和发音有对应关系,见到一个生词,哪怕不认识,也大概能拼出来。
但在中文面前,这条捷径彻底不存在了。他看到“河”这个字,他不知道自己应该在脑子里发出什么声音;看到“哭”,嗯,他只能通过字形,大概猜出这里面有某种意象。
但跨过这道门槛之后,他还是被深深地震撼了。字母文字是“入门简单,越走越难”——新词爆炸,专业壁垒越来越厚;而中文是“入门难,越走越容易”——一旦掌握了基础汉字的组合逻辑,后续学新词的速度会越来越快,因为你不必每次都学一个全新的字母序列。
哈里森教授还提到了一个让他在学术论坛上反复引用的例子——中文的阅读认知实验。
根据国内教育部语言文字应用研究所的一项研究数据,同等知识水平的受试者,在阅读陌生的科普词汇时,中文母语者的猜词正确率明显高于英语母语者。
原因很简单:中文母语者只要掌握了三千五百个常用汉字,基本上就能读懂绝大多数报刊、科普读物和日常文献,覆盖日常阅读场景的百分之九十九以上。
而英语母语者想要达到同样的无障碍阅读水平,需要一万五千以上的词汇量,并且还必须不断学习新增词汇才能跟上科技迭代的速度。
这个数据真实地反映出了两种语言在底层架构上的差异。
人工智能大模型兴起之后,哈里森教授的另一个观察引发了更多讨论。他在跟科技公司的朋友交流时发现,很多大模型训练研究员有一个共识:在处理高度复杂的指令时,用简短的中文描述,模型往往更容易抓住核心意图。
中文那种高度凝练、重语义关联、擅长组合生成的特点,跟人工智能语义推理的需求有一种天然的契合感。
不过在海外学术论坛里,也有不少学者提出了不同的意见。有语言学家提出,汉字识记周期长,标准化输入在很长一段历史时间里都是难关,智能手机和输入法技术的成熟才解决了这个短板。
还有学者认为信息效率不能只看字符长短,要结合大脑解码消耗——汉字识别对于视觉记忆的负荷更高,长时间阅读在某种程度上可能比拼读系统更消耗注意力。
这些观点各有各的道理,而这种讨论本身就说明了“语言优劣论”是多么站不住脚。每一种语言都是漫长的历史演进中自然形成的交流工具,都有最适合自己族群的表达路径。
哈里森教授这场“中文之旅”的分享,在国内外的传播过程中,逐渐被简化成一则“中文碾压其他语言”的标题党新闻,显然偏离了他本来的意愿。
也并不是说中文有什么超自然力量,从信息科学的维度回看,好代码能同时做到简洁、稳定、可扩展,而汉字恰恰在意外间满足了这些条件。
这也像极了一场跨越时空的巧合。几千年前,那些甲骨文上的刻痕显然不可能预知人工智能时代,凭什么这套古老的表意体系能兼容未来文明的需求?
原因在于它从未僵化过。从甲骨文、金文、小篆到隶书楷书,再到今天的现代汉语,汉字整套系统一直在吸收新概念、演化新形态,但底层那个基础字符稳定、可组合、可拓展的框架几千年来从未崩塌。
佛教传入时如此,近代西学东渐时也是如此,互联网时代更是如此。
在人类文明史上,那些古老的楔形文字、圣书字,基本都成了博物馆里无人能读的死文字,唯有汉字一脉相承,至今仍是活着的日常工具。
今人读千年前的典籍,依然能读懂文字内核。这在世界文明谱系中是极其罕见的奇迹。
哈里森教授那篇感慨走红后,很多中国人才突然意识到,自己每天都在用的母语,居然藏着这么精巧的编码逻辑。习惯了组词造句,习惯了望文生义,觉得这一切都再自然不过。
很多时候,只有听了外部的声音,人们才会注意到自己的母语到底有多特别。
百年之前,中国曾经一度有一种文化自卑达到了极点,甚至出现了“汉字落后论”。有人主张废除汉字、改用拉丁字母拼写。因为那些声音认为汉字效率低、难普及、难工业化。
当时有一批热血青年,为了“现代化”而呐喊。如果当时按照那些人的激进主张去做了,现在就不可能是今天的局面。
今天回头再看,这种短视早已不言自明。
那一代代的文字学者、语言研究者,坚守着汉字体系,在不断改良中建立起了现代汉语词汇体系,才让它平稳跨过了工业化、信息化时代,一直走到人工智能蓬勃发展的今天。
语言这个东西,说来也很奇怪。会某种语言的人觉得它不值钱,因为每天都在用,用得太多了,太习以为常了。但恰恰是这种“习以为常”,才是数千年文明积淀发酵后的自然状态。
真正的好语言,其实就应该像一栋老房子,住了几千年,一直在翻修刷新,但地基从来不需要重建。而地球对面那些不断造新词的字母文字,支撑的更多是短期通行方案,适应的是不断迭代、反复更新的快餐信息环境。
最后那句话说得很好:世界上的各种语言,没有高下之分,只有不同的设计思路和适配套路。但中国有底气,把自己的母语和文字,与其他优秀的人类文明形态共同放在这个地球上,还能坦然地说一句——这套东西我用了五千年,它还没坏,而且它还能接着用。
申宝配资提示:文章来自网络,不代表本站观点。
- 上一篇:威力财 菊花柠檬茶的隐藏功效,不止清热降火这么简单
- 下一篇:没有了


沪深京行情 实时轮播
热点资讯


